International Cancer Pathology Company(ICPC)は、腫瘍の病理画像からがん細胞を検出する人工知能(AI)モデルの開発に取り組む会社です。前処理の段階で、AI モデルは病理画像上の細胞核を検出し、図 12 のように、各細胞核をいわゆる「バウンディングボックス」で囲みます。バウンディングボックスは 4 つ組 $(x_1,y_1,x_2,y_2)$ で表される長方形で、$(x_1,y_1)$ は左上の角の座標、$(x_2,y_2)$ は右下の角の座標です。AI モデルが描いたバウンディングボックスを検出ボックスと呼びます。
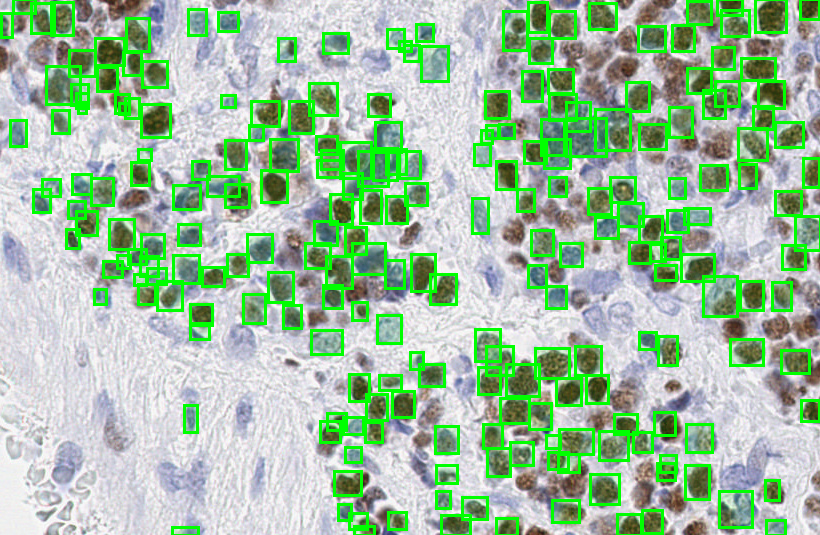
図 12:検出ボックスを含む病理画像。*
AI モデルの性能を評価するため、ICPC の研究者はテストデータ(病理画像)の集合を用意し、医療専門家の協力で、テストデータの正解(実際の細胞核)をあらかじめバウンディングボックスで注釈付けします。これらを正解ボックスと呼びます。その後、研究者は AI モデルをテストデータに適用して細胞核を検出し、正解の細胞核がいくつ検出されたかを調べます。正解ボックス $G$ を持つ細胞核は、$G$ の面積の少なくとも半分だけ $G$ と重なる検出ボックス $D$ が存在するとき、すなわち $|D\cap G|/|G|\ge1/2$ のとき、AI モデルによって検出されたといいます。1 つの検出ボックスが 2 つ以上の正解ボックスと重なることがありますが、その検出ボックスによって検出されたといえるのは 1 つだけです。図 13 に正解ボックスと検出ボックスの例を示します。また、細胞核のサイズが限られているため、バウンディングボックスの幅と高さにも上限があります。
正解ボックスの集合と検出ボックスの集合が与えられたとき、検出された細胞核の最大個数を求めるプログラムを書いてください。
入力
最初の行には、テストケースの数を表す整数 $t$ が含まれます。各テストケースの最初の行には、空白で区切られた 2 つの整数 $m$ と $n$ が含まれ、それぞれ正解ボックスと検出ボックスの個数を表します。続く $m+n$ 行は、バウンディングボックスの座標の 4 つ組 $(x_1,y_1,x_2,y_2)$ を表し、隣接する整数は空白で区切られます。最初の $m$ 行は正解ボックスを、次の $n$ 行は検出ボックスを表します。
- 図の画像は、次の URL にある論文から引用しています: https://www.kitware.com/cell-nuclei-detection-on-whole-slide-histopathology-images-using-histomicstk-and-faster-r-cnn-deep-learning-models/
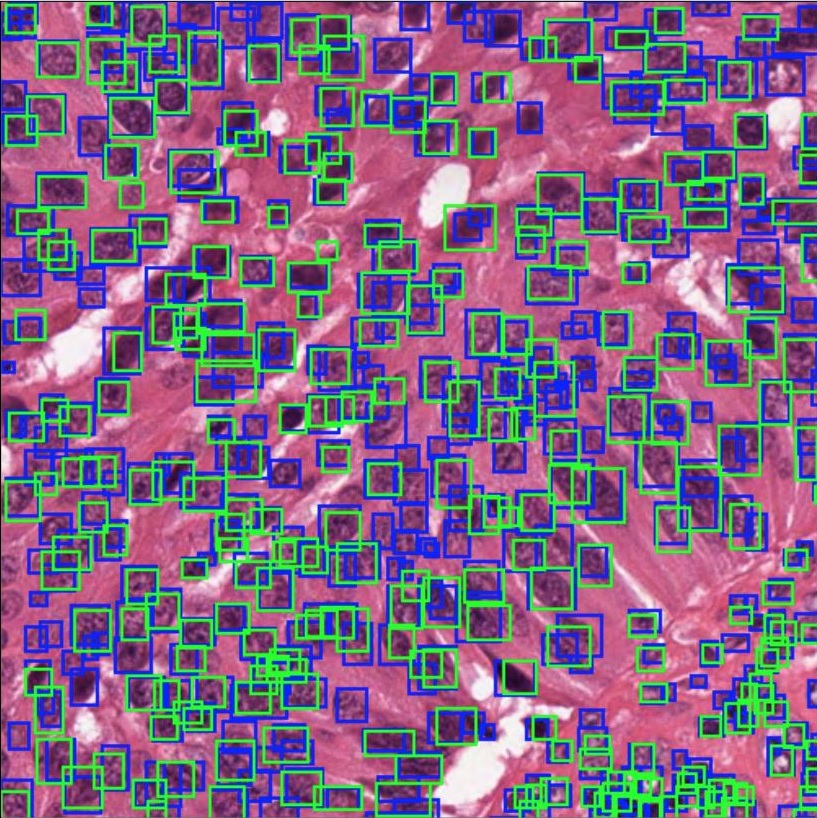
図 13:正解ボックス(青い枠)と検出ボックス(緑の枠)を含む病理画像。*
制約
$1\le t\le5$.
$1\le m,n\le50\,000$.
$0\le x_1,y_1,x_2,y_2\le2000$.
変数 $t,m,n,x_1,y_1,x_2,y_2$ は整数です。
バウンディングボックスの幅と高さの最大長は 4 です。
どの 2 つの正解ボックスも、一方が他方を含むという包含関係を持ちません。どの 2 つの検出ボックスについても同様です。
出力
各テストケースに対して、1 行に整数 $k$ を 1 つ出力します。$k$ は、与えられた検出ボックスで検出された細胞核の最大個数です。
入出力例
入力 1
3
2 2
1 1 3 3
3 3 5 5
2 2 4 4
4 4 6 6
2 3
1 1 3 3
3 3 5 5
1 3 3 5
2 1 4 5
3 1 5 3
3 3
1 1 2 2
2 2 3 3
3 3 4 4
1 1 3 3
2 2 4 4
3 3 5 5
出力 1
0
1
3